AI 代理問答拿高分,為什麼試辦還要測一遍真實工作流程?
AI 代理問答拿高分,不代表能在資訊不全、要跨系統取資料時做完工作。本文說明問答測試與互動任務的差別,並示範試辦時如何設計追問、權限與成果檢查,避免把問答高分誤當成交付能力。
假設一位營運主管在供應商的展示會上看到一段示範:AI 代理回答公司請假制度與產品規格的問題,每題都答得快又準,評分表幾乎滿分。他心想,要是它能接手「新客戶開通」,團隊每週就能少做很多來回確認。問題是,回答制度問題,和替一位新客戶把帳號、方案與通知全部做完,真的是同一種能力嗎?
這裡說的 AI 代理,是被安排去查資料、追問、操作工具,並以交出成果為目標的 AI 系統,和只在聊天視窗裡回答問題的 AI 不同。判斷它好不好用,看的不是答得多漂亮,而是事情有沒有做完。
本文要回答兩件事:問答分數高,能說明什麼、不能說明什麼;試辦時該怎麼設計測試,才看得出代理會不會在缺資料、權限有限、需要多步往返的工作裡卡住。
問答分數量到的是哪一種能力
本文說的靜態問答,是指主辦方先準備一組固定題目,代理看到題目後直接作答,再依答案打分。它量的是代理在這組題目上的作答情形。中途追問、再去查另一個系統,或依前一步結果調整下一步,都不在這組題目的評分範圍內。
2026 年有一項企業評估研究,把測試分成兩類:一類是基礎企業推理,包括資訊擷取、數值計算、領域知識與複雜推理;另一類是互動式決策,包括顧問情境、供應鏈模擬與企業營運模擬。這份研究刊在 arXiv 上。arXiv 是研究者公開放置論文的網站,上面的版本屬於預印本,也就是作者先行公開的版本,不等於已通過期刊或會議正式審查的定稿,讀它的結論時要先記得這一點。
研究的主要觀察是:在它測試的代理方法與模型組合中,靜態問答表現較好,並不代表它們在顧問、供應鏈或企業營運等互動任務也會較好;作者報告,靜態問答的強項不會可靠地轉移到互動任務。
這不是說展示沒有用,而是展示回答的是另一個問題。讀到高分時,主管可以先問:這組題目有沒有要求代理自己找資料、自己判斷缺了什麼?如果沒有,高分就只能說明它在那組題目上答得好。
互動任務多了什麼
研究裡的顧問測試,可以看出差別。代理一開始只拿到一段商業問題,案例中的其他資訊是隱藏的。它得自己提問,把拿到的資料整理成分析,最後提出建議。評分看的是整段對話,以及最後那份建議。
這跟固定題目不同的地方,在於代理能不能察覺自己缺了什麼。顧問測試中,代理只有先提問,才能拿到其餘的案例資訊。若它沒有追問,只拿已知條件作答,回覆仍可能讀起來很完整,卻建立在缺漏的資料上。
另一個例子是 Beer Game(一個模擬補貨決策的互動遊戲)。代理只看見局部的庫存等狀態,每一步決定要訂多少;出貨有延遲,所以今天下的訂單,影響要過幾步才會顯現。研究以累積成本評估表現。這類任務的難點不在某一題答對與否,而在前面的決定,會在後面才露出結果。
這些互動測試是在受控的基準環境中進行,沒有完整涵蓋真實企業裡的社會、組織與制度因素。所以它說明的是:互動能力要另外測。它不能用來推論某個模型或供應商在一般企業一定會失敗。
「做完」還要看權限與最後狀態
2025 年一篇已發表的研究,在一個模擬企業環境(研究裡稱為沙盒,指用模擬資料搭起來的測試環境)中做測試,設計了 500 項企業任務,並把多步推理、存取權限與跨職能流程都納入其中。這個沙盒使用合成的企業資料,包括聊天紀錄、電子郵件與 GitHub 活動等,不是哪一家公司的真實資料。
以其中一項任務為例:請代理建立 GitHub 儲存庫(軟體團隊存放程式與專案檔案的線上空間),並通知主管。任務表列的工具包括建立儲存庫、寄送郵件與讀取員工資料。一句話看似簡單,但要真正交付,代理得建立儲存庫、取得寄件人與主管的資料,再產生通知並寄出。缺了任何一步,請求都還沒有完成。
權限也是其中一環。研究中的工具輸出受存取控制約束,權限不只是任務描述裡的背景說明。代理能不能讀到某份資料,要看系統實際給它什麼權限,不是看題目裡寫它「應該」可以。
評分也不是只看代理說了什麼。研究會看最後的執行是否正確;對建立、讀取、更新、刪除類任務,會先讀回系統裡的操作結果,再根據讀到的內容評分。代理說已完成,仍要回到系統看它是否真的完成。
試辦時,用一個任務問三個問題
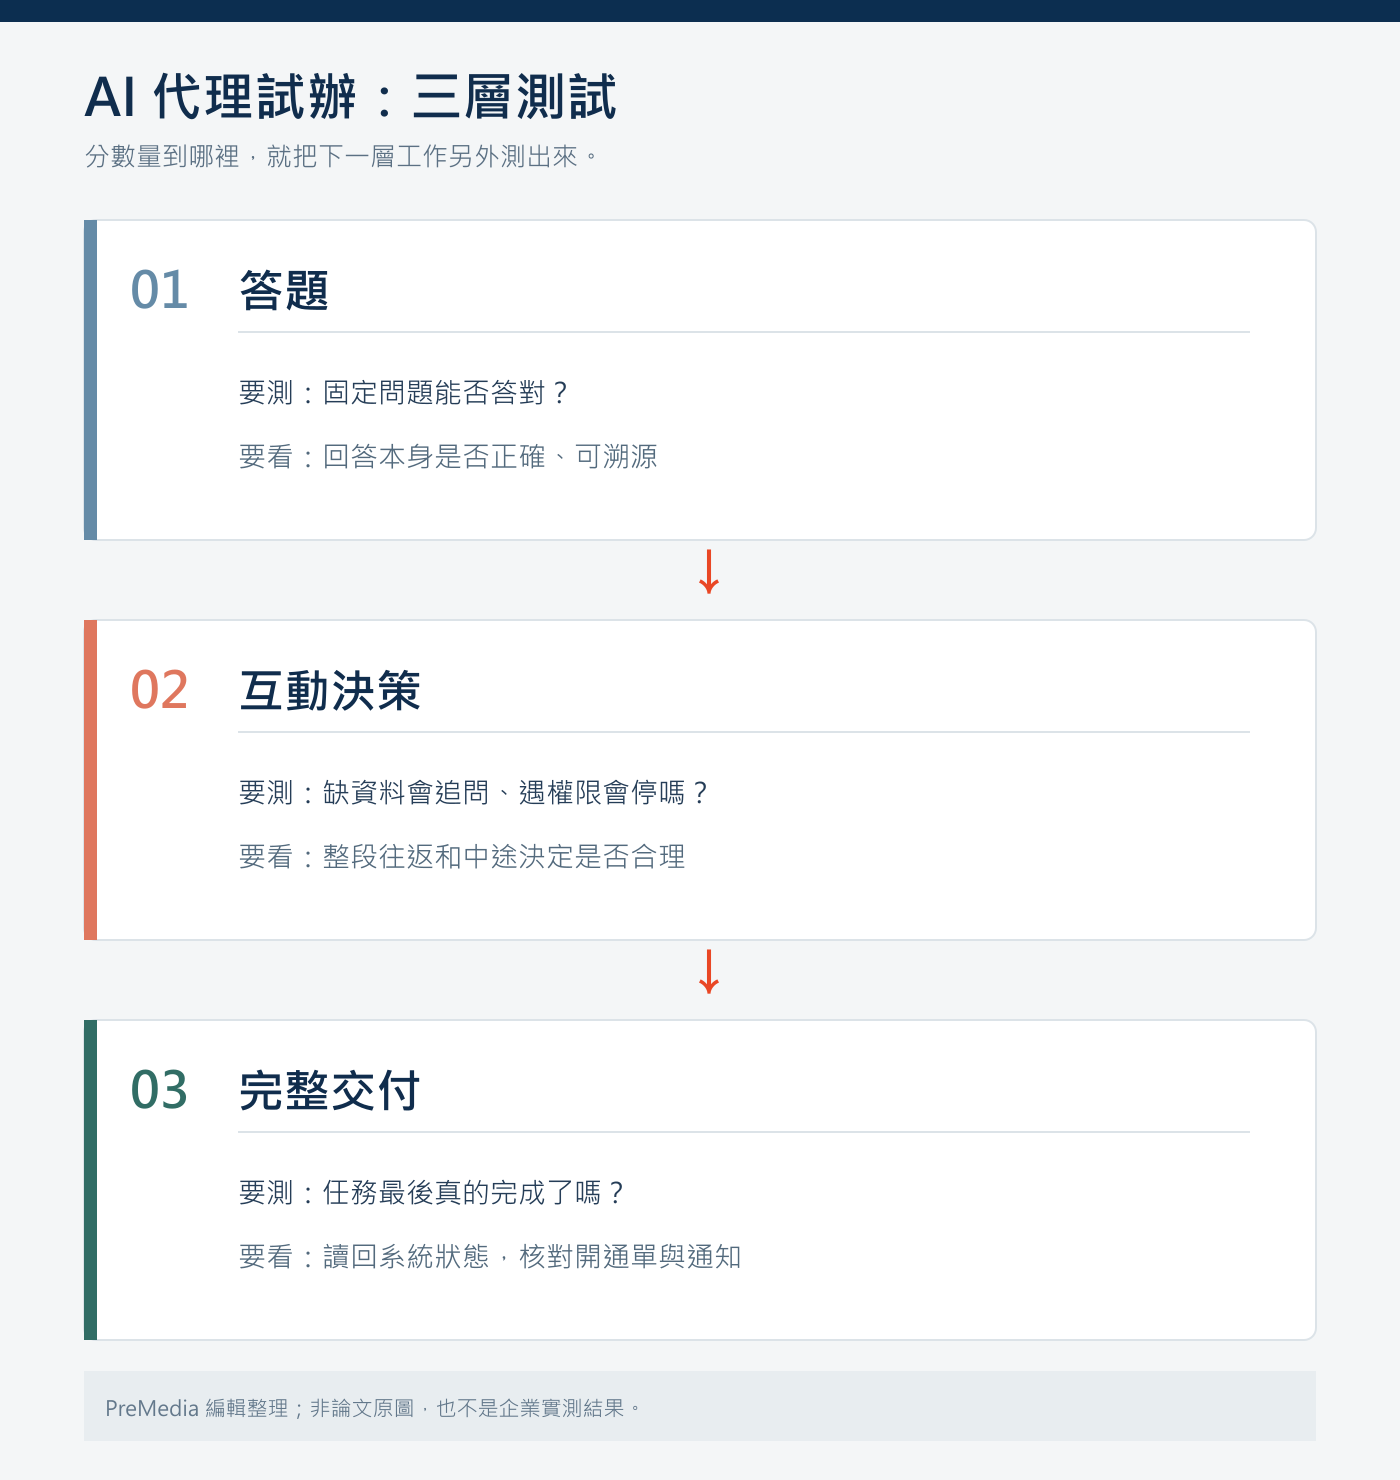
PreMedia 依本文整理的試辦檢查架構;不是兩篇論文的原圖,也不是企業實測結果。
以下用一個假設的「新客戶開通」試辦任務,走過三個設計問題:業務送出需求,代理查客戶資料,在授權範圍內建立開通單,並通知相關主管。下面三個安排是 PreMedia 依前面兩項研究做的編輯判斷,不是研究作者為企業開出的試辦處方。
第一個問題:缺資料時,它會不會問?
假設業務的需求單只寫了客戶名稱與要開通的服務,沒有寫付款方案。這時代理應該先追問方案,而不是套用一個預設值。若它直接套用預設值,開通單會看起來很完整,但內容可能跟客戶實際約定的不一樣。試辦時就把這個缺漏放進去,觀察它有沒有停下來問。
第二個問題:每一步能碰哪些資料?
同一個任務裡,假設代理的帳號能查客戶基本資料,卻查不到計費系統。它要核對業務補上的付款方案,就得靠計費系統,這一步卡住了。遇到這種情況,代理應該停在這裡,不建立開通單,也不自行猜方案或另找管道取得資料,並把待處理事項交給 IT 窗口。研究的沙盒中,工具輸出同樣受存取控制約束,所以這條停止規則要在試辦前寫清楚,否則代理碰到權限邊界時,沒有人知道該怎麼處理。
第三個問題:交出什麼成果?誰依什麼標準檢查?
這裡有兩條路。第一條是權限不足:代理停在計費系統那一步,還沒有開通單,因此不進入成果檢查;試辦負責人要確認代理有停下來,而且待處理事項確實交到 IT 窗口。第二條是權限補上:IT 處理後,代理重新查到計費資料,才繼續建立開通單,並寄出通知信給相關主管。只有走到這一條,才會有成果可以檢查。
第二條路的檢查,是在代理完成後看系統裡的結果。檢查的人不只看代理的回覆,還要到系統裡讀回開通單,對照事先定好的清單,例如客戶名稱、已確認的付款方案、開通日期與通知對象是否正確。這個做法和研究評分時先讀回系統操作結果的作法相近。代理回覆寫著已完成,不能據此倒推它前面的追問與權限都做對。
試辦時兩條路都要安排到,才知道代理在權限不足與權限已補上兩種情況下各自的表現。這只說明這個任務上的表現,不保證正式部署一定成功。研究的互動測試在受控基準環境中進行,未完整涵蓋真實企業的社會、組織與制度因素,所以試辦結果還要放回自家的組織與人員安排中來看。
回到那場展示。高分說明代理在那組題目上的作答情形;試辦要問的是,在缺資料、權限有限、需要多次往返時,它能不能留下可以核對的正確結果。想先了解導入前還要準備哪些條件,可以看企業導入 AI Agent 指南;AI 代理的基本工作方式,則可參考AI 代理是什麼?。
資訊截至 2026 年 10 月。
資料來源
- arXiv,EnterpriseBench: Benchmarking LLM Agents on Enterprise-Level Strategic Reasoning and Decision-Making:https://arxiv.org/abs/2609.37658(2026-09-29)
- ACL Anthology,Can LLMs Help You at Work? A Sandbox for Evaluating LLM Agents in Enterprise Environments(EMNLP 2025):https://aclanthology.org/2025.emnlp-main.466.pdf(2025-11)