Embedding 是什麼?AI 如何判斷兩句話意思很像
Embedding 是什麼?本文用退款與客服知識庫的例子,解釋文字如何轉成向量、AI 如何比較語意相似度,以及 Embedding 在語意搜尋、向量資料庫與 RAG 中的用途和限制。
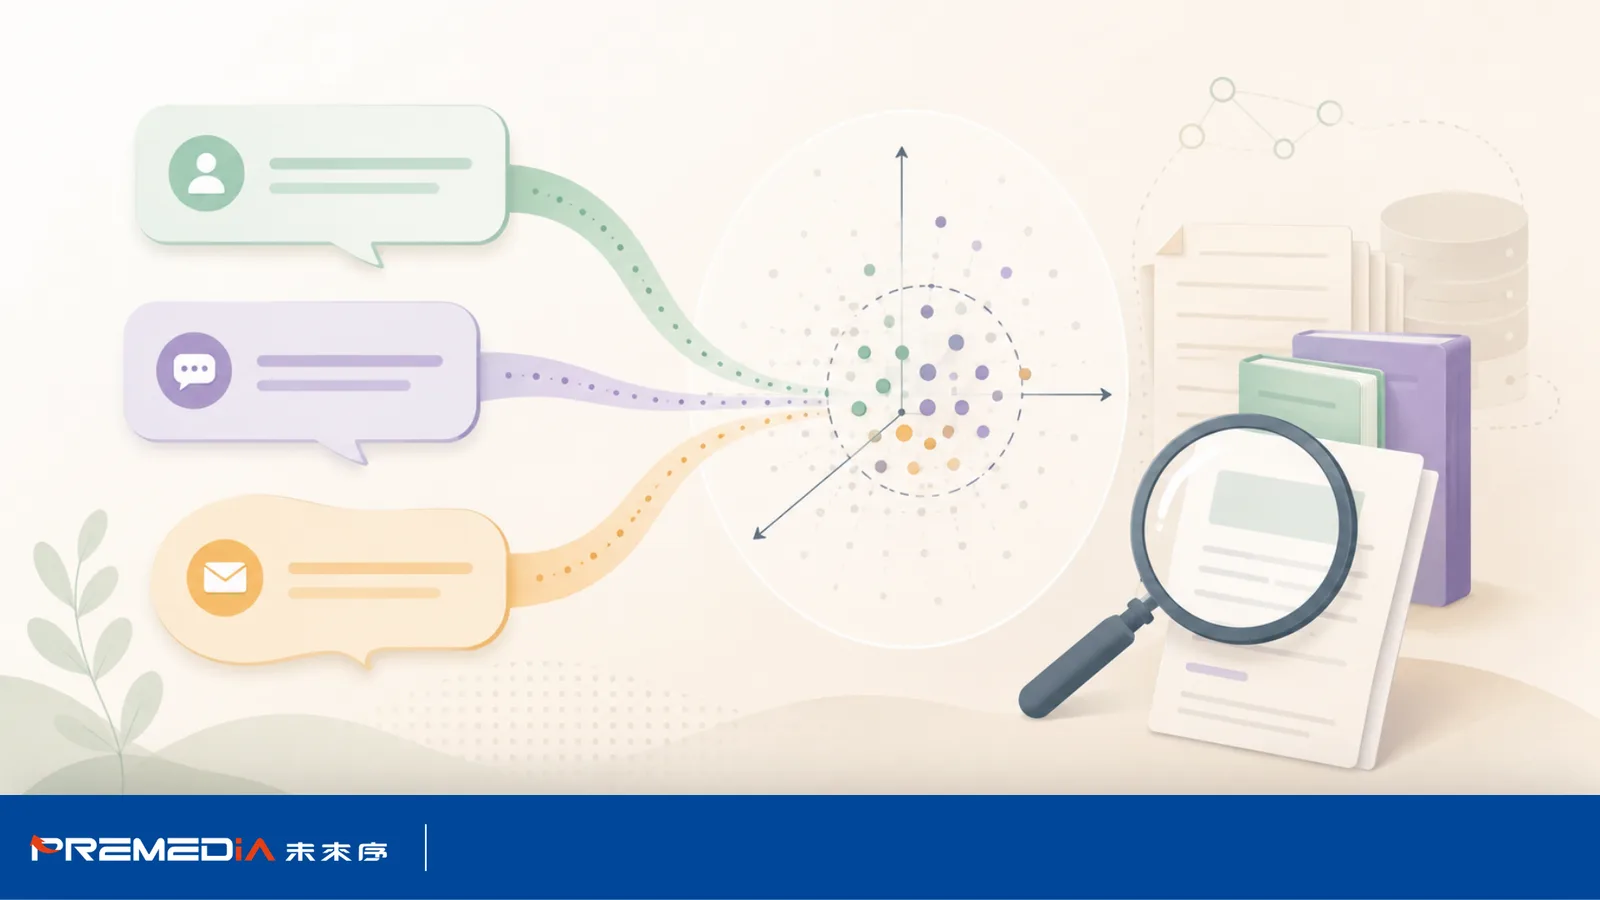
我要退款、我想退貨、這筆訂單我不想要了,這三句話的用字不完全一樣,但多數人一看就知道,它們都和「退貨退款」有關。AI 之所以能做出類似判斷,不一定是因為它像人一樣真正理解了整件事,而是因為系統會先把文字轉成一組可以計算和比較的數字。
這種數值表示方式,就是 Embedding。
簡單來說,Embedding 解決的是一個很實際的問題:當兩段內容沒有使用相同關鍵字,但意思很接近時,系統要怎麼把它們找出來?
Embedding 是什麼?先把它想成「意思座標」
Embedding 中文常被翻成「向量嵌入」或「向量表示」。它會把一句話、一段文字、圖片或其他資料,轉成一串數字,也就是向量,你可以先把它想成「意思座標」。
人類看到兩句話時,會憑語感判斷它們像不像;電腦則需要把內容轉成某種可以計算的形式,才知道哪些內容意思接近、哪些問題屬於同一類、哪些文件應該被放在一起。
如果AI只單看關鍵字,那很有可能會誤解語意中真正的意思,Embedding 的價值,就是讓系統不只比對字面,而是比對「意思是不是接近」,這也是它和單純全文搜尋、關鍵字搜尋最不一樣的地方。
AI 如何用 Embedding 判斷兩句話的語意相似度?
AI 並不是看到兩句話後憑直覺說「這兩句很像」,而是經過文字轉換、相似度計算和結果排序。
第一步:把每句話轉成向量
假設使用者輸入:我上週買的耳機壞掉了,可以退嗎?
系統會先透過 Embedding 模型,把這句話轉成一串數字,知識庫裡的退貨規則、保固政策和配送說明,也會事先轉成向量。
這時,使用者的問題和每一段文件都變成可以計算的形式。
第二步:計算向量有多接近
接著,系統會比較問題向量與文件向量,算出兩者的相似程度。。
假設「瑕疵商品退換貨」的相似度為 0.91,「修改收件地址」只有 0.28,系統就會優先顯示前者。
可以特別注意的是,不同模型的分數範圍和判讀方式不一定相同,因此不能看到 0.8 就直接認定「一定正確」,也不適合拿不同模型的分數直接比較。
第三步:把最接近的內容排在前面
Embedding 負責的是找出「可能相關」的內容,而不是直接判斷顧客到底能不能退款。
以耳機故障為例,系統可能先找出瑕疵退貨、保固換貨和一般退貨規則,再由後續程式或語言模型整理答案。真正能不能退,仍要看購買日期、商品狀況、退貨政策和保固條件。
Embedding 擅長的是相似度比對,不是法律判斷、政策裁定或完整的情境理解。
Embedding 和關鍵字搜尋有什麼不同?
如果系統只使用關鍵字搜尋,通常會檢查查詢和文件中有沒有出現相同字詞。
例如,使用者搜尋「退貨」,系統便找出包含「退貨」的文件。這種方法處理產品型號、訂單編號和法規名稱時很有效,但碰到不同說法時,可能會漏掉相關內容。
假設客服文件寫的是「取消購買」,使用者問的卻是「這筆訂單不想要了」,兩邊沒有完全相同的字,傳統關鍵字搜尋便可能找不到。
Embedding 比較的是語意接近程度,因此更有機會抓到不同用字背後的相同意圖。
| 搜尋情境 | 關鍵字搜尋 | Embedding/語意搜尋 |
|---|---|---|
| 搜尋產品型號 AB-9280 | 較適合 | 可能不夠穩定 |
| 搜尋「商品不要了怎麼辦」 | 可能漏掉退貨規則 | 較容易找到相關內容 |
| 搜尋完整法規名稱 | 較適合 | 可作為補充 |
| 整理不同說法的客服問題 | 容易受字面限制 | 較適合 |
| 企業知識庫搜尋 | 適合精確詞彙 | 適合語意查詢 |
實務上不一定要二選一,更好的做法,是把關鍵字搜尋和向量搜尋結合成「混合搜尋」。語意搜尋負責找到意思相近的內容;關鍵字搜尋則保留產品編號、專有名詞、日期和精確數字。
Embedding 的 4 個常見應用場景
Embedding 不一定直接幫你回答,但它會負責把「該找哪份資料」這一步做得更準。以下幾種情境,都是 Embedding 經常發揮作用的地方:
1. 語意搜尋
當你在知識庫、客服系統或文件系統裡搜尋問題時,Embedding 可以幫系統找到意思最接近的段落,而不是只找字面完全一樣的句子。
例如,員工搜尋「出差費用要怎麼申請」,即使公司文件使用的是「差旅報銷流程」,系統仍可能找出相關規定。
2. RAG 和知識庫問答
很多 AI 問答系統不會只依賴模型原本記住的知識,而是先從企業文件中找出相關內容,再根據找到的資料整理答案。
這種做法通常稱為 RAG,也就是檢索增強生成,Embedding 常被用在 RAG 的檢索階段,系統也可能加入關鍵字搜尋、篩選條件和重新排序模型,讓檢索結果更穩定。
📌 延伸閱讀:RAG 是什麼?企業 AI 知識庫最重要的第一步
3. 推薦系統
不管是文章推薦、商品推薦還是影片推薦,系統都可能需要知道哪些內容彼此相近,Embedding 很適合處理這件事。
當系統知道哪些內容彼此接近,便能推薦主題相似的文章、功能相近的商品,或與使用者興趣較接近的內容。
4. 分類和去重
如果你要整理大量留言、客服工單、文章標題或產品描述,Embedding 可以協助把相似內容聚在一起。
例如,「刷卡一直失敗」、「信用卡付不了」和「付款沒有成功」可以先被聚集在同一群,再交由付款問題的客服人員處理。
Embedding 一定要搭配向量資料庫嗎?
不一定。Embedding 模型負責產生向量;向量資料庫則負責儲存向量,並快速找出相似的資料,兩者解決的是不同問題。
當資料量很小時,系統可以直接計算每筆向量之間的相似度,不一定需要另外導入向量資料庫;但文件一多,每次都和所有資料逐筆比較,速度便會變慢,這時通常會使用向量索引或支援向量搜尋的資料庫,加快查找速度。
所謂「向量資料庫」,不一定是完全獨立的新系統,有些傳統資料庫、雲端資料庫或搜尋服務,也提供向量儲存與相似度搜尋功能。
企業選擇工具時,不能只看搜尋速度,資料位置、權限管理、更新頻率、篩選需求與系統整合,也都會影響選擇。
因此,不要因為要使用 Embedding,就急著把所有資料搬進新的資料庫。
Embedding 很重要,但它不是萬能的通靈大師
Embedding 很擅長判斷「意思接近」的內容,但不代表它真的像人一樣理解完整背景、責任歸屬或例外情況。
即使你現在沒有自己做 AI 系統,也可以先做一個簡單練習:
找一組你工作裡常見、但說法很多變的問題,例如客戶退貨、請假流程、報銷規則、訂單修改,然後把不同說法列出來。像是「我要退貨」、「我想退貨」、「商品可以退嗎」、「這筆訂單不想要了」,這些句子字面上不完全一樣,但背後的意思其實很接近。
接著你可以問自己:如果只靠關鍵字搜尋,會不會漏掉一些其實很像的說法?如果答案是會,那你其實已經碰到 Embedding 想解決的問題了。
要記得,Embedding 通常只是 AI 流程中的其中一步,很多 AI 系統會先用 Embedding 找出相關資料,再交給語言模型整理成答案。Embedding 可以幫 AI 更準確地找到資料,但如果原本的文件過時、互相矛盾、命名混亂,Embedding 也不會自動把壞資料變成好資料。
所以在使用 Embedding 之前,還是要先整理好資料內容、命名方式和文件版本,AI 才有機會找得到真正有用的答案。
Embedding 不是讓 AI 更會說,而是讓系統更容易找出彼此相近的內容,它最常出現在語意搜尋、RAG、知識庫問答、推薦系統和相似內容整理裡。
當你理解這個概念之後,就比較不會把 AI 的能力全部都想成「模型自己突然懂了」,而會知道很多時候,它其實是先靠一層語意比對把資料找對。
常見問題
Q1:Embedding 和關鍵字搜尋有什麼不同?
關鍵字搜尋主要檢查文字是否出現;Embedding 則把查詢和文件轉成向量,再比較語意上的接近程度。
關鍵字搜尋適合產品編號、完整名稱和精確數字;Embedding 則比較擅長處理不同用字但意思相近的查詢。實務上,兩者經常搭配使用。
Q2:AI 如何判斷兩句話意思很像?
系統會先把兩句話分別轉成向量,再使用餘弦相似度、點積或距離函數計算接近程度。
分數越接近,通常代表模型認為兩句話越相似,但高相似度不等於內容一定正確。
Q3:Embedding 和 RAG 是一樣的東西嗎?
不一樣。
Embedding 是把內容轉成向量的方法;RAG 則是先搜尋資料,再由語言模型根據資料產生答案的完整流程。
Embedding 常用在 RAG 的檢索階段,但不是 RAG 的全部。
Q4:Embedding 一定需要向量資料庫嗎?
不一定。
資料量較小時,可以直接計算向量相似度。當資料量變大,才比較需要使用向量索引或支援向量搜尋的資料庫,提高查找速度。
Q5:Embedding 相似度越高,答案就一定正確嗎?
不一定。
高相似度只代表模型認為兩段內容接近,不代表文件是最新版本,也不代表內容符合當下的政策、資格或例外條件。
Q6:Embedding 只有工程師需要懂嗎?
不是。
負責客服、知識庫、文件管理、產品規劃或企業 AI 導入的人,也需要理解 Embedding 的用途和限制。
這樣在搜尋結果不準時,才知道問題可能出在模型、文件、切分方式、搜尋條件,還是資料版本。
如果你對 AI Agent 提升企業效率、工作流程應用有興趣,歡迎訂閱我們📱💻
PreMedia 未來序|帶你建立AI 時代企業新秩序
參考資料
Google Cloud Documentation,〈Get text embeddings〉。
Reimers, N., & Gurevych, I.(2019),〈Sentence-BERT: Sentence Embeddings using Siamese BERT-Networks〉。
Lewis, P. et al.(2020),〈Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks〉。
Microsoft Learn,〈在 Azure AI 搜尋中使用向量和全文搜尋的混合式搜尋〉。
pgvector,〈Open-source vector similarity search for Postgres〉。